
에이전트 모드와 예산 가드
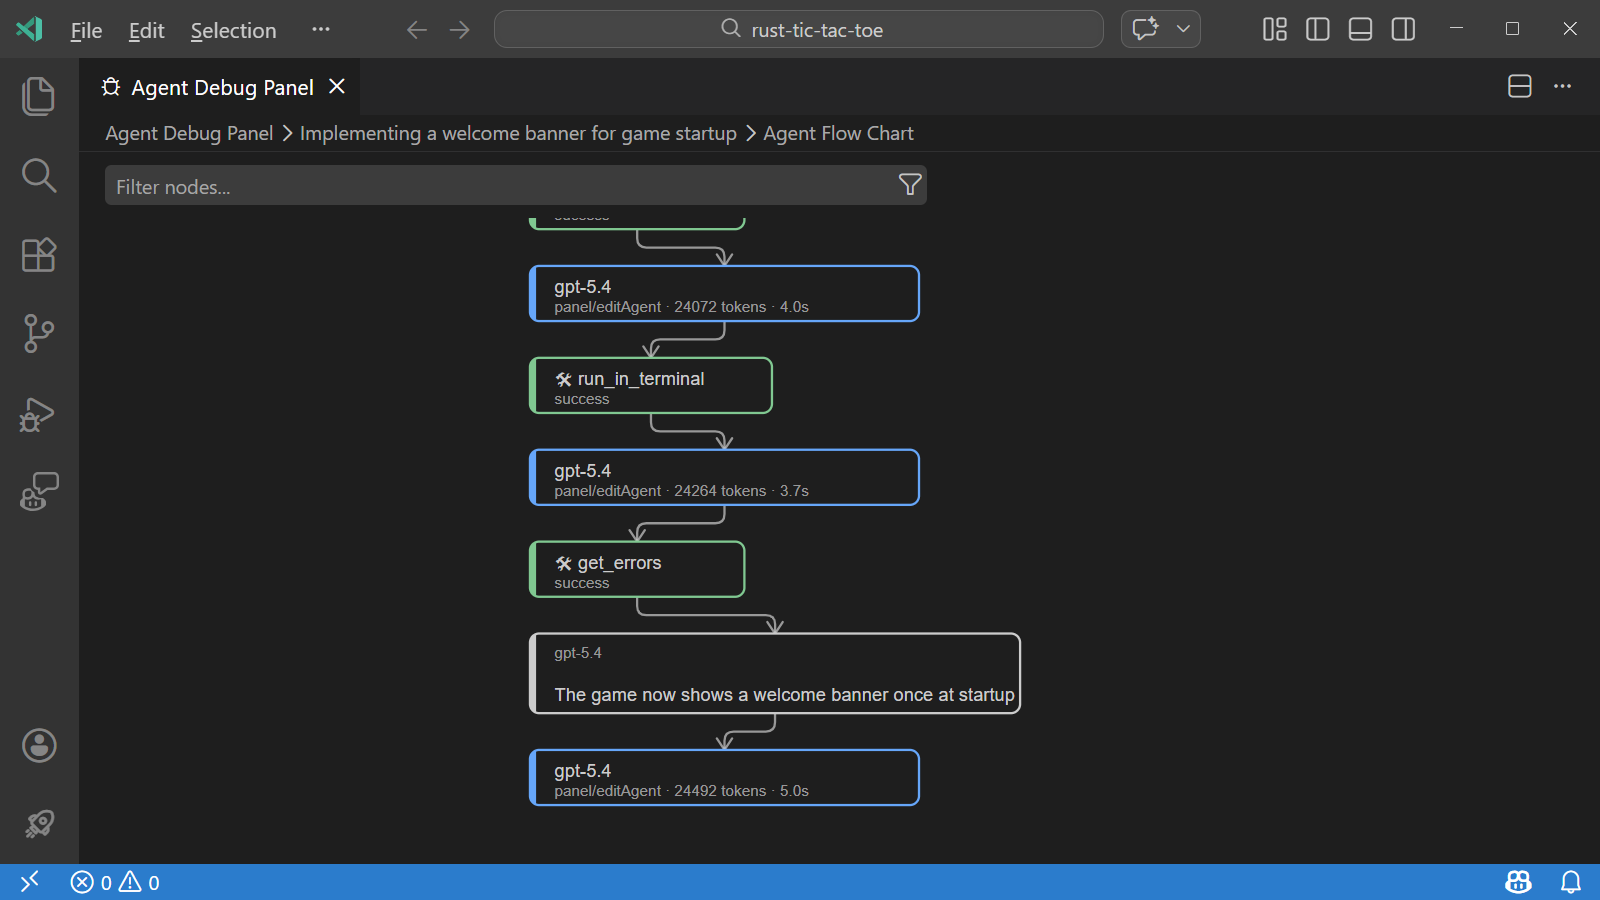
에이전트 실행은 루프입니다. 각 단계가 모델 호출이며, 호출할 때마다 지침, 도구 정의, 지금까지의 대화가 다시 전송됩니다. 프롬프트가 모호하면 에이전트가 오래 탐색한 끝에 의도를 잘못 이해해 처음부터 다시 시작해야 할 수 있습니다.
상황에 맞는 가장 저렴한 모드를 선택합니다
섹션 제목: “상황에 맞는 가장 저렴한 모드를 선택합니다”| 모드 | 일반적인 형태 | 용도 |
|---|---|---|
| Ask | 모델 호출 1회 | 질문, 설명, 조회 |
| Plan | 계획 단계 1회 | 코드를 작성하기 전에 변경 범위 정리 |
| Agent | 다수의 호출(도구 루프) | 여러 파일에 걸친 리팩터링, 처음부터 기능 구현 |
질문에는 Ask를 기본으로 사용하고, 범위를 명확히 할 때는 Plan을 사용합니다. 작업에 정말로 도구가 필요할 때만 Agent를 사용합니다. 비용이 큰 패턴은 모호한 프롬프트로 Agent를 실행하는 것입니다.
루프를 제한합니다
섹션 제목: “루프를 제한합니다”chat.agent.maxRequests— 한 번의 실행에서 에이전트가 보낼 수 있는 최대 요청 수입니다(2026-11-03 기준으로 확인한 VS Code 설정 참조 문서의 기본값은 25). 루프가 걷잡을 수 없이 늘어나는 것이 걱정되면 값을 낮추고, 긴 작업이 필요한 경우에만 높입니다.- 에이전트가 탐색을 멈추도록 명확한 완료 기준을 지정합니다(예: “완료 = 테스트 통과, lint 오류 없음”).
- 복잡한 작업은 에이전트가 먼저 계획 파일을 작성한 뒤 실행하게 합니다.
- 사용할 도구를 알고 있다면 이름을 지정해(“GitHub create-PR 도구만 사용”) 도구 탐색을 줄입니다.
- 구체적인 컨텍스트(파일, 오류 메시지, 제약 조건)를 제공합니다(컨텍스트를 간결하게 유지하기 참조).
Autopilot이나 백그라운드 에이전트에는 작업 프롬프트에 명시적인 루프 가드를 추가하세요.
먼저 관련 범위의 테스트를 실행하세요. 같은 명령이나 테스트가 같은 오류로 두 번 실패하면 반복 재시도하지 말고 멈춰서 장애 원인을 보고하세요.이는 강제 실행 제한이 아닌 지시입니다. 로그를 확인하고 요청 또는 예산 한도도 추가 안전장치로 사용하세요.
모델과 추론
섹션 제목: “모델과 추론”- 기본값으로 자동 모델 선택을 사용합니다. 계획 단계에는 더 강력한 모델을, 범위가 정해진 구현에는 더 저렴한 모델을 지정합니다(모델, 계획, 위임 참조).
- 자동 선택은 편리하지만 비용 최적화 도구는 아닙니다. 지출을 제어하는 데 의존하기 전에 모델 선택 방식을 문서에서 확인합니다.
- 추론 강도(thinking effort)는 기본값으로 둡니다. 어려운 문제에서만 높입니다. 강도가 높을수록 추론 토큰이 늘어나 비용과 지연 시간이 커집니다.
- 모델을 바꾸면 프롬프트 캐시가 새로 시작됩니다. 캐싱은 공급자, 모델, 배포마다 별도로 동작하므로, 세션 중간에 모델을 바꾸면 이전 캐시를 재사용하지 못합니다.
Copilot 클라우드 에이전트(이슈 → PR)
섹션 제목: “Copilot 클라우드 에이전트(이슈 → PR)”클라우드 에이전트 작업 하나가 많은 토큰을 사용할 수 있습니다. 시작 비용을 줄이는 방법은 다음과 같습니다.
- 이슈를 정확하게 작성합니다. “이거 고쳐줘”가 아니라 수락 기준(테스트 또는 동작), 재현 단계, 관련 파일 링크, 명확한 범위를 포함합니다.
- 리포지토리의 Copilot setup steps 워크플로(
.github/workflows/copilot-setup-steps.yml)에서 종속성을 미리 설치하고 빌드를 미리 실행합니다. 에이전트가 매번 환경을 새로 파악하지 않아도 됩니다.
한도가 적용되는 위치
섹션 제목: “한도가 적용되는 위치”사용량 기반 청구에서는 편집기 내 루프 제한 외에 GitHub의 계정 수준 예산 제어(예: 사용자별 또는 코스트 센터별 지출 한도)도 사용할 수 있습니다. 요금제에서 현재 지원하는 옵션은 GitHub Docs에서 확인하세요. Copilot을 호출하는 자동화(CI 리뷰, 생성된 테스트, 검사)는 실행할 때마다 크레딧을 소비한다는 점에 유의합니다.
확인 방법
섹션 제목: “확인 방법”각 모드가 적합한 작업을 골라 여러 단계로 이루어진 작업을 Ask, Plan, Agent로 한 번씩 실행하고, 세션 크레딧과 Agent Debug Logs의 도구 호출 수를 비교합니다. 루프가 요청 한도에 걸려서가 아니라 사용자가 정한 완료 기준에서 끝나는지 확인합니다.
트레이드오프
섹션 제목: “트레이드오프”maxRequests를 너무 낮게 설정하면 정당한 긴 작업이 중간에 끊겨, 이미 쓴 토큰이 낭비될 수 있습니다. 한도를 지나치게 낮추기보다 명확한 완료 기준과 계획 파일을 우선합니다.
추가 자료(논문)
섹션 제목: “추가 자료(논문)”학회 등급, 인용 수 순으로 정렬했습니다. 각 연구 결과는 가설이므로 자신의 워크로드에서 검증해야 합니다. 전체 목록은 논문을 참고하세요.
- Training Language Models to Reason Efficiently — NeurIPS 2025, 인용 285회. 정확도와 추론 길이 사이의 균형을 조절하도록 추론 모델을 학습시킵니다.
- Token-Budget-Aware LLM Reasoning — ACL 2024, 인용 259회. 문제마다 토큰 예산을 추정해 chain-of-thought 추론을 짧게 만듭니다.
- Do NOT Think That Much for 2+3=? On the Overthinking of o1-Like LLMs — 프리프린트 2024, 인용 605회. o1 계열 모델이 단순한 질문에도 지나치게 많은 토큰을 쓴다는 점을 보이고, 이를 줄이는 방법을 제안합니다.
- Agentless: Demystifying LLM-based Software Engineering Agents — 프리프린트 2024, 인용 566회. 위치 파악, 수정, 검증으로 이루어진 고정 파이프라인이 낮은 비용으로 SWE-bench Lite에서 개방형 에이전트 루프와 경쟁할 수 있음을 보여 줍니다.
- L1: Controlling How Long A Reasoning Model Thinks With Reinforcement Learning — 프리프린트 2025, 인용 416회. 사용자가 지정한 길이 예산을 따르도록 추론 모델을 학습시킵니다.
- Efficient Agents: Building Effective Agents While Reducing Cost — 프리프린트 2025, 인용 40회. 에이전트 시스템을 설계할 때 효율과 효과 사이의 트레이드오프를 체계적으로 연구합니다.
- VS Code Copilot settings reference (
chat.agent.maxRequests) - Optimize AI credit usage in VS Code
- Customize the cloud agent environment (copilot-setup-steps.yml)
- Token Efficiency and Context Engineering — 개발자 발표 자료(2026년 6월). 모드 비교와 클라우드 에이전트 팁(정성적인 내용만 참고했으며, 발표 자료의 토큰 수치는 이 문서에 재현하지 않음)