
컨텍스트를 가볍게 유지하기
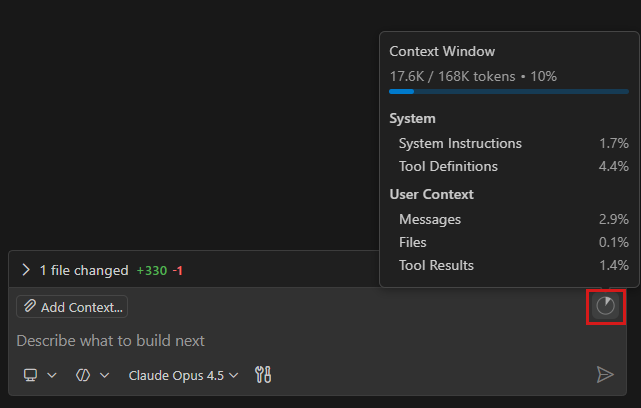
대화가 이어지면 메시지, 도구 출력, 파일 내용이 쌓입니다. 새 요청을 보낼 때마다 이 기록이 입력으로 다시 전송되므로, 관련 없는 이전 주제에도 토큰이 계속 소비됩니다.
컨텍스트 윈도우와 컨텍스트 열화
섹션 제목: “컨텍스트 윈도우와 컨텍스트 열화”컨텍스트 윈도우는 모델이 한 요청에서 처리할 수 있는 최대 범위이며, 입력과 출력이 이 범위를 함께 사용합니다. 컨텍스트 윈도우에는 최대 한도가 있지만, 그 한도에 도달하기 훨씬 전부터 답변 품질이 떨어질 수 있습니다. 모델이 긴 컨텍스트의 중간에 있는 정보를 처음이나 끝에 있는 정보보다 덜 안정적으로 활용하기 때문입니다(Lost in the Middle). 따라서 비용과 품질을 모두 고려해 작업에 필요한 정보는 충분히 제공하되 불필요한 컨텍스트는 제거해야 합니다.
| 상황 | 조치 |
|---|---|
| 관련 없는 작업으로 전환할 때 | 새 채팅 세션을 시작합니다(Ctrl+N / ⌘N). |
| 다른 방법을 시도하거나 곁가지 질문을 하고 싶을 때 | 다시 설명하는 대신 대화를 포크합니다(/fork 또는 메시지에 마우스를 올린 뒤 Fork Conversation). |
| 긴 세션을 계속 사용해야 할 때 | /compact를 실행해 이전 턴을 요약합니다(/compact focus on the API design decisions처럼 초점을 지정할 수도 있습니다). |
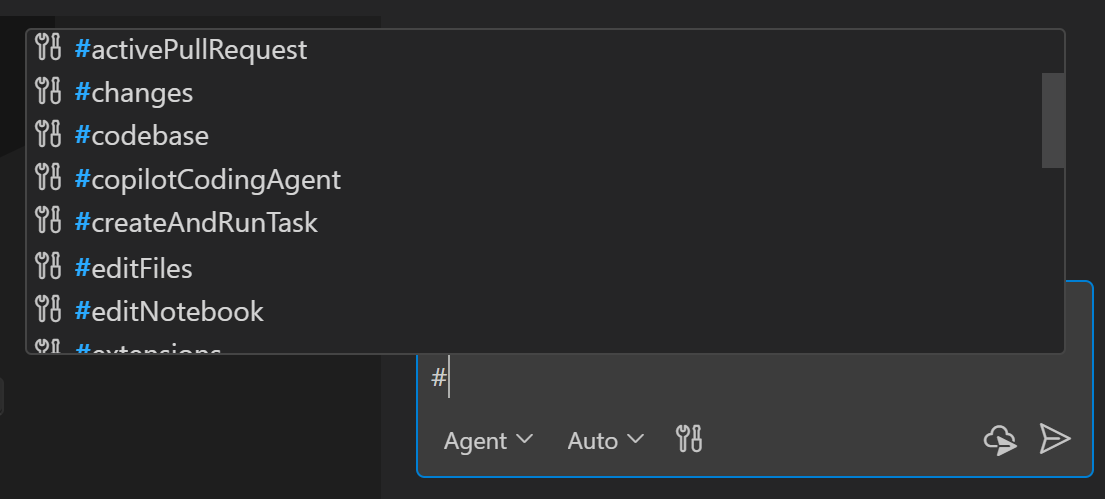
| 관련 코드를 알고 있을 때 | 에이전트가 넓게 검색하도록 두지 말고 파일, 폴더, 심볼을 #으로 직접 지정합니다. |
| 코드베이스 검색이 필요할 때 | #codebase는 검색을 실행합니다. 코드베이스 전체를 컨텍스트에 추가하지는 않습니다. |
반복적인 grep + view 왕복으로 작업이 느려지고 이력이 비대해질 때 | VS Code Marketplace에서 Code Context (cctx)를 설치해 블록 단위로 클램핑된 #cctxNativeContext 1회 조회(<8 KiB 인라인 예산, 웜 탐색 15.20배 가속 및 작업 완료 시간 24.7% 단축 보고)를 사용합니다. |
| 검색 결과에 로그, 빌드 출력, 생성된 파일이 많이 섞일 때 | 제외합니다. .gitignore(인덱스와 에이전트 검색), files.exclude(완전히 숨김), search.exclude(에이전트 검색에서만 숨김)를 사용합니다. |
| 웹 참조가 필요할 때 | URL과 함께 #fetch는 필요할 때만 사용합니다. 가져온 페이지는 컨텍스트에 들어갑니다. |
| 독립적인 조사가 필요할 때 | 서브에이전트에 위임해 탐색 과정이 메인 대화에 남지 않게 합니다. |
검색에서 일치한 스니펫은 에이전트가 해당 파일을 열지 않아도 컨텍스트 윈도우에 포함됩니다. 따라서 노이즈가 많은 경로를 제외하면 곧바로 효과가 있습니다.
서브에이전트 위임의 손익분기 기준
섹션 제목: “서브에이전트 위임의 손익분기 기준”서브에이전트에 위임하면 탐색 중간 결과가 메인 채팅의 컨텍스트 윈도우에 쌓이지 않지만, 서브에이전트의 첫 턴에도 자체 시스템 프롬프트와 도구 스키마 접두부 비용이 듭니다. 실용적인 기준으로 도구 호출 5회 이하의 짧은 조회는 메인 채팅에서 직접 처리하세요. 이후 메인 세션의 턴마다 중간 출력이 불어날 수 있는 광범위한 조사나 여러 파일 탐색만 위임합니다. 격리에는 비용이 드므로 작업 성공 여부와 비용을 함께 측정하세요.
확인 방법
섹션 제목: “확인 방법”변경 후 사용량 측정의 기준선 작업을 다시 실행하고, 세션 크레딧과 컨텍스트 윈도우 토큰 수를 비교합니다. 답변 품질이 유지되는지도 확인합니다.
트레이드오프
섹션 제목: “트레이드오프”/compact로 요약하면 일부 정보가 사라질 수 있습니다. 계속 필요한 세부 정보가 요약 과정에서 사라질 수 있습니다. 초점 지시를 추가하고, 반드시 남겨야 할 내용(결정 사항, 제약 조건, 파일 경로, 미해결 항목)을 명시합니다.- 컨텍스트 압축은 기록의 시작 부분을 바꾸므로 해당 접두부에 대한 제공자의 프롬프트 캐시가 다시 만들어집니다. 반복하지 말고 작업이 자연스럽게 끊기는 시점에 한 번만 압축합니다. 남은 작업이 짧다면 그냥 끝내는 편이 더 저렴한 경우가 많습니다.
- 긴 세션에서 큰 도구 결과(파일 읽기, 명령 출력)가 대부분을 차지한다면, 대화를 요약하는 것보다 이러한 결과를 줄이거나 짧은 인수인계 메모와 함께 새 채팅을 시작하는 편이 대체로 더 효과적입니다.
- 새 채팅을 시작하면 기록이 사라집니다. 오래 유지할 사실은 사용자 지정 지침에 넣어 매번 다시 설명하지 않도록 합니다.
- 가능한 모든 컨텍스트가 아니라, 작업을 성공시키는 데 필요한 최소한의 신뢰할 수 있는 컨텍스트만 첨부합니다.
추가 자료(논문)
섹션 제목: “추가 자료(논문)”학회 등급, 인용 수 순으로 정렬했습니다. 논문의 결과는 각자의 워크로드에서 검증해야 하는 가설입니다. 전체 목록은 논문을 참조합니다.
- Lost in the Middle: How Language Models Use Long Contexts — TACL 2023, 인용 5,818회. 관련 정보가 긴 입력의 중간에 있으면 정확도가 떨어집니다.
- Large Language Models Can Be Easily Distracted by Irrelevant Context — ICML 2023, 인용 1,358회. 프롬프트에 관련 없는 컨텍스트가 있으면 모델 정확도가 크게 낮아질 수 있습니다.
- LLMs Get Lost In Multi-Turn Conversation — ICLR 2025, 인용 562회. 모델은 요구 사항이 불충분한 멀티턴 대화에서 단일 턴보다 성능이 떨어집니다.
- Same Task, More Tokens: the Impact of Input Length on the Reasoning Performance of Large Language Models — ACL 2024, 인용 270회. 입력 길이만 따로 분리해, 입력이 길어질수록 추론 성능이 떨어짐을 보여 줍니다.
- The Complexity Trap: Simple Observation Masking Is as Efficient as LLM Summarization for Agent Context Management — 프리프린트 2025, 인용 66회. 에이전트 컨텍스트 관리에서 단순한 관찰 마스킹이 LLM 요약만큼 효율적입니다.