
Copilot 사용량은 어떻게 과금되는가
비용을 줄이려면 먼저 과금 방식을 알아야 합니다. 현재 두 가지 과금 모델이 있으며, 각 모델에 맞는 절약 방법이 다릅니다.
달라진 점
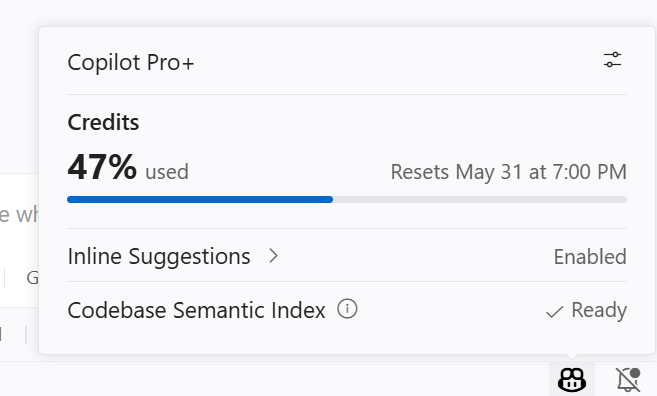
섹션 제목: “달라진 점”- 사용량 기반 과금(현재). GitHub은 2026년 6월 1일부터 Copilot 사용량에 GitHub AI 크레딧을 차감한다고 발표했습니다. 크레딧은 모델과 처리한 토큰 수에 따라 다른 비율로 차감됩니다. 각 플랜에는 월별 기본 제공량이 포함됩니다.
- 기존 프리미엄 요청 과금. 기존 연간 플랜을 사용하던 일부 Pro/Pro+ 구독자는 요청 기반 과금을 유지했습니다. 이 방식에서는 채팅에서 보낸 프롬프트 하나가 모델 배수를 곱한 프리미엄 요청 1건으로 계산되며, 에이전트 실행 중의 자율적인 도구 호출은 따로 계산하지 않습니다.
| 사용량 기반(AI 크레딧) | 기존 방식(프리미엄 요청) | |
|---|---|---|
| 단위 | 토큰 × 모델 요율 | 프롬프트 × 모델 배수 |
| 긴 채팅 기록 | 비용 증가(입력으로 다시 전송) | 토큰 단위로 과금하지 않음 |
| 큰 도구 목록/지침 | 비용 증가(요청마다 전송) | 토큰 단위로 과금하지 않음 |
| 가장 효과적인 방법 | 컨텍스트 축소, 적절한 모델 선택 | 프롬프트 수 감소, 배수가 낮은 모델 선택 |
절약 방법을 고르기 전에 GitHub Copilot 청구 설정에서 사용 중인 플랜을 확인하세요.
모든 요청에서 토큰이 중요한 이유
섹션 제목: “모든 요청에서 토큰이 중요한 이유”요청할 때마다 입력 토큰(시스템 프롬프트, 지침, 도구 정의, 지금까지의 전체 대화, 첨부 파일, 도구 결과)을 보내고 출력 토큰(추론 토큰 포함)을 받습니다. 대화가 길어질수록 입력이 늘어나므로, 오래된 컨텍스트에도 비용이 반복해서 듭니다. 제공자는 변경되지 않은 요청 접두부를 재사용할 수 있으며(프롬프트 캐싱), 요청의 앞부분이 안정적으로 유지되면 비용과 지연 시간이 줄어듭니다.
캐시된 입력과 과금
섹션 제목: “캐시된 입력과 과금”접두부 캐시에 적중하면 AI 크레딧 과금에서는 cached_input_tokens에 일반 입력 요율 대신 해당 모델의 할인된 캐시 읽기 요율이 적용됩니다. 기존 프리미엄 요청 과금에서는 캐시 적중 여부와 관계없이 프롬프트당 1 × 모델 배수만큼 요청을 사용합니다. 다만 캐싱은 지연 시간과 속도 제한 부담을 줄이는 데 도움이 될 수 있습니다. 모델 선택기에 마우스를 올려 적용 요율을 확인하고 Agent Debug Logs에서 요청의 캐시 사용량을 살펴보세요. 실제 청구 내용은 플랜의 사용량 보고서에서도 확인합니다.
트레이드오프
섹션 제목: “트레이드오프”이 가이드의 방법은 컨텍스트와 비용 사이에서 균형을 잡는 데 도움이 됩니다. 모델에 필요한 컨텍스트를 제거하면 재시도와 재작업이 생기고, 절약한 것보다 비용이 더 들 수 있습니다.