
모델, 계획, 위임
토큰당 가장 저렴한 모델이 작업 결과를 얻는 데도 가장 저렴한 것은 아닙니다. 잘못된 접근으로 곧바로 코드를 작성하면 세션 전체가 낭비될 수도 있습니다.
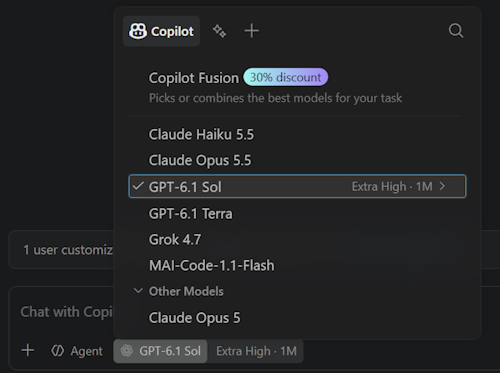

- 측정 결과를 바탕으로 모델을 선택합니다. 기대하는 결과와 평가 방법을 먼저 정의합니다. 출력은 비결정적이므로 후보 모델마다 두 번 이상 실행합니다. 완료 여부, 품질, 안정성, 소요 시간, 크레딧을 비교하고, 기준을 꾸준히 충족하는 가장 저렴한 모델을 고릅니다. 모델이 바뀌면 다시 평가합니다.
- 관리하기 쉬운 기본 설정: 자동 모델 선택을 사용합니다. 반복되는 워크플로에서는 사용자 지정 에이전트에 모델을 고정합니다.
- 사고 강도는 기본값으로 둡니다. 강도를 높이면 사고 토큰이 늘어나 비용과 지연 시간이 커집니다. 아키텍처 계획이나 여러 단계의 디버깅처럼 정말 복잡한 작업에서만 높입니다.
- 계획한 다음 구현합니다. 성능이 높은 모델로 Plan 에이전트를 실행하고 계획을 검토한 뒤, 범위가 명확한 작업으로 나눕니다. 각 작업은 더 저렴한 모델, 작업에 맞는 지침, 최소한의 도구를 갖춘 사용자 지정 서브에이전트에 위임합니다. 기본 에이전트가 결과를 검토합니다.
실패와 재시도의 역설
섹션 제목: “실패와 재시도의 역설”단순화하면 total cost = rate × calls × accumulated context입니다(accumulated context는 호출당 평균 토큰 수). 가상의 예로 토큰 요율이 프런티어 모델의 3분의 1인 모델이 테스트 루프에서 네 번 실패한 뒤 성공하면, 호출당 평균 컨텍스트가 같더라도 한 번에 성공한 프런티어 모델 비용의 최소 1/3 × 5가 듭니다. 도구 출력이 쌓여 컨텍스트가 커지면 비용은 더 늘 수 있습니다. 실제 청구에서는 입력, 캐시된 입력, 출력의 요율도 구분합니다. 모델을 비교할 때는 작업 성공 기준을 같게 유지하고 재시도, 도구 출력, 최종 성공 실행까지 포함하세요.
확인 방법
섹션 제목: “확인 방법”반복되는 작업 유형에서 (a) 성능이 높은 모델 하나로 처음부터 끝까지 수행한 경우와 (b) 성능이 높은 모델로 계획하고 더 저렴한 모델로 작업자를 구성한 경우를 비교합니다. 크레딧, 재시도 횟수, 결과가 인수 기준을 충족하는지 기록합니다.
트레이드오프
섹션 제목: “트레이드오프”- 위임 자체도 토큰을 사용합니다. 격리와 저렴한 모델의 이점이 오케스트레이션 오버헤드를 상쇄하지 못하는 작은 작업은 메인 세션에서 처리합니다.
- 저렴한 모델을 사용하더라도 재시도나 재작업이 필요하면 전체 비용이 더 커질 수 있습니다.
추가 자료(논문)
섹션 제목: “추가 자료(논문)”학회 등급, 인용 수 순으로 정렬했습니다. 논문의 결과는 각자의 워크로드에서 검증해야 하는 가설입니다. 전체 목록은 논문을 참조합니다.
- FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance — TMLR 2023, 인용 1,247회. LLM을 선택하고 연쇄 호출해 더 낮은 비용으로 강력한 모델에 가까운 품질을 얻습니다.
- Hybrid LLM: Cost-Efficient and Quality-Aware Query Routing — ICLR 2024, 인용 519회. 라우터가 질의의 난이도를 예측해 쉬운 질의를 더 작은 모델로 보냅니다.
- AutoMix: Automatically Mixing Language Models — NeurIPS 2023, 인용 169회. 작은 모델이 자신의 답을 스스로 검증하게 하고, 필요할 때만 더 큰 모델로 넘깁니다.
- Cost-of-Pass: An Economic Framework for Evaluating Language Models — ICLR 2025, 인용 56회. 정답을 얻는 데 드는 기대 비용을 정의하고, 이를 기준으로 모델을 비교합니다.
- RouteLLM: Learning to Route LLMs with Preference Data — 프리프린트 2024, 인용 922회. 선호도 데이터로 학습해 질의를 강력한 모델과 더 저렴한 모델 사이에서 라우팅합니다.